
Sauvegarder un gros volume de données, c'est comme repeindre un mur entier parce qu'une seule touche a été abîmée. Même si 2 % des fichiers ont changé depuis la veille, l'outil de sauvegarde repart souvent de zéro et recopie l'intégralité du volume. Des heures de copie, de la bande passante et de l'espace de stockage gaspillés pour rien.
Ne recopier que ce qui a changé
Pour comprendre l'idée, revenons au fonctionnement classique. L'outil de sauvegarde prend un instantané du volume, c'est-à-dire une photo figée des données à un instant précis, puis il recopie cette photo en entier. Que 99 % du contenu soit identique à celui de la veille ne change rien : la copie est complète.
Le suivi des blocs modifiés inverse la logique. Un « bloc » est un petit paquet de données du disque, l'unité de base du stockage. Entre deux instantanés, l'API dresse la liste des blocs qui ont réellement bougé et la met à disposition des logiciels de sauvegarde. Eux n'ont plus qu'à recopier cette liste courte, au lieu de tout avaler.
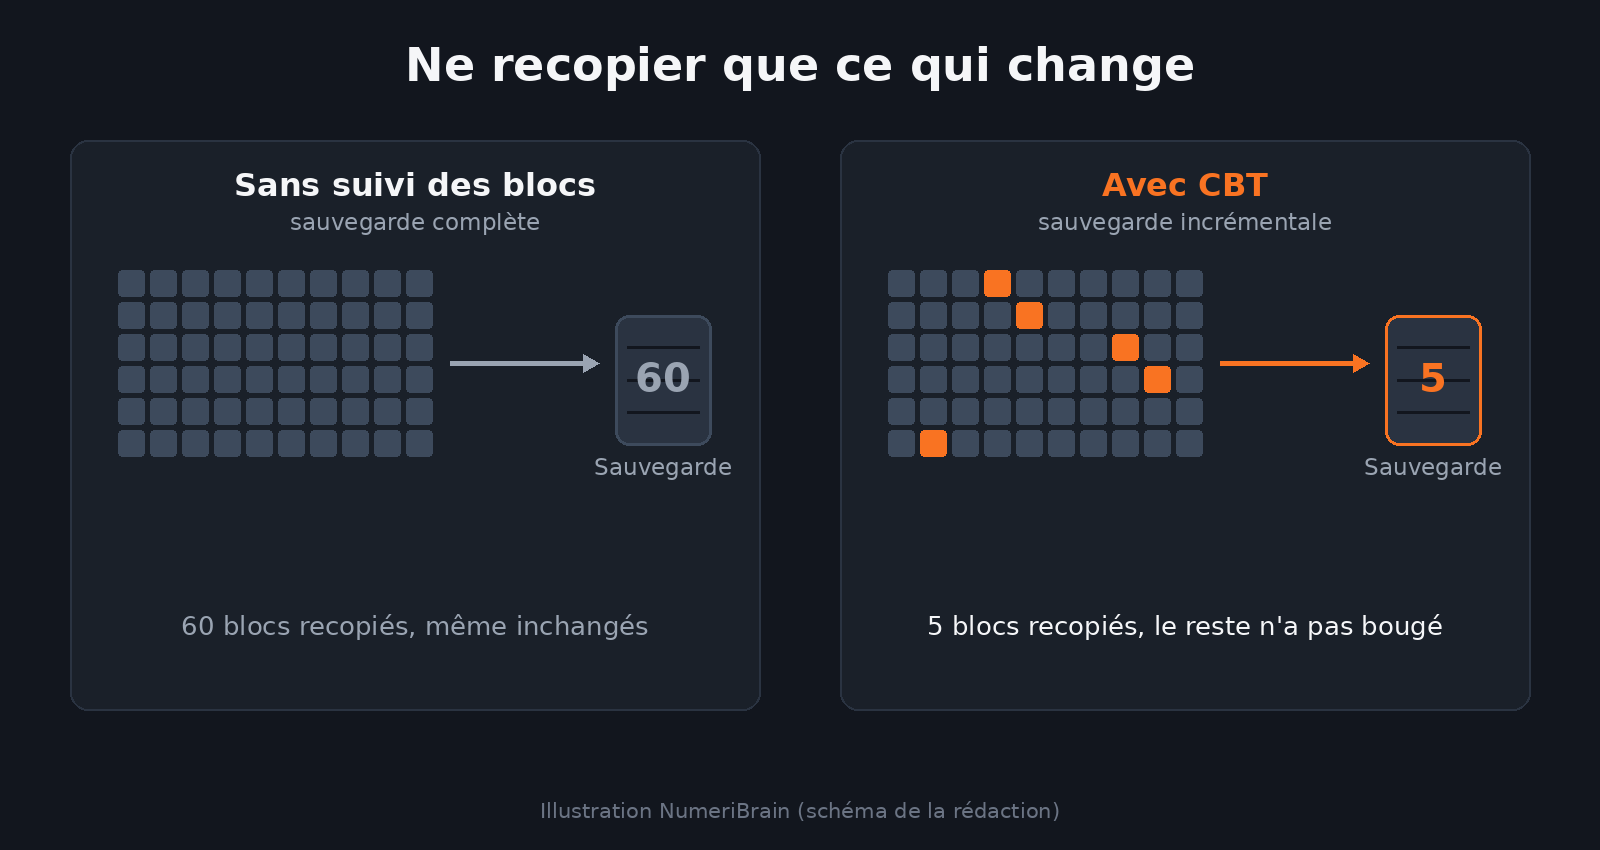
Schéma explicatif réalisé par la rédaction NumeriBrain, d'après la documentation du projet Kubernetes. Ce n'est pas une capture du produit.
Dans la pratique, Kubernetes expose deux fonctions aux développeurs : l'une liste les blocs présents dans un instantané, l'autre liste ceux qui diffèrent entre deux instantanés. Les applications de sauvegarde n'ont plus qu'à s'y brancher. C'est aussi pour ça que cette étape compte : le projet Kubernetes appelle maintenant les éditeurs de solutions de sauvegarde et les auteurs de pilotes de stockage à adopter l'API.
Concrètement, ça change quoi pour toi ?
Si tu gères déjà des applications sur Kubernetes, l'intérêt se joue sur trois tableaux : la durée des sauvegardes, la bande passante consommée et l'espace de stockage occupé. Un cluster avec de grosses bases de données peut voir ses sauvegardes incrémentales devenir bien plus rapides, puisque seuls les blocs modifiés traversent le réseau.
L'autre bénéfice, c'est la fréquence. Quand une sauvegarde complète prend des heures, on la lance une fois par nuit, au mieux. Une sauvegarde incrémentale de quelques minutes peut être déclenchée plusieurs fois par jour. En cas de pépin, on perd donc beaucoup moins de travail.
Pour le grand public, l'effet sera indirect mais réel. Cette mécanique existe depuis longtemps dans le monde des machines virtuelles, où VMware la propose sous le même nom ; son arrivée dans Kubernetes rapproche le monde des conteneurs de cette maturité. Les offres de sauvegarde gagnent en efficacité, et les factures de stockage suivent.
✉️ Un moment, avant de continuer la lecture…
Le rendez-vous du dimanche : un extrait de la chronique « Un pavé dans la tech », les 4-5 infos qui comptent et un aperçu de la semaine à venir. Inscription gratuite, désinscription en un clic.
Ce qu'il faut pour en profiter
Ce n'est pas un interrupteur à basculer d'un clic. Quelques conditions doivent être réunies, résumées ici :
- Un cluster Kubernetes en version 1.33 minimum, avec des volumes de type bloc, ces disques « bruts » qu'utilisent en général les bases de données.
- Un pilote de stockage compatible : chaque fournisseur (cloud public, baie de disques, solution logicielle) livre son propre pilote CSI, le composant qui fait le lien entre Kubernetes et le stockage. C'est lui qui doit implémenter le suivi des blocs.
- Un pilote à jour : la version bêta impose la spécification CSI 1.10 ou plus récente.
- Un logiciel de sauvegarde capable de parler à cette nouvelle API, côté application.
La bonne nouvelle : les outils de sauvegarde du marché devraient intégrer ce mécanisme progressivement, sans que tu aies à changer tes habitudes. La moins bonne : tant que ton pilote de stockage ne suit pas, l'API ne te servira à rien, quel que soit ton outil de sauvegarde.
Les limites à connaître
Première limite, déjà évoquée : seuls les volumes de type bloc sont concernés. Les volumes fichiers, les partages réseau de type NFS par exemple, passent à côté pour l'instant. Si ton stockage est un simple partage de fichiers, le suivi des blocs ne s'appliquera pas.
Deuxième point : le passage en bêta casse la compatibilité avec l'alpha. La définition du service est passée de la version v1alpha1 à v1beta1, et l'ancienne a été retirée, pas juste doublée. Les premiers testeurs, qui pouvaient essayer la version alpha depuis septembre 2025, doivent mettre à jour leurs fichiers de configuration : aucune conversion automatique n'est prévue.
Enfin, tout ça reste une interface pour développeurs, pas un produit fini. La version finale arrivera après l'adoption et les retours d'usage, et personne ne donne de date. Pour suivre l'avancement, le dépôt du projet publie le code et des exemples prêts à tester.
Sources
Le billet du blog officiel de Kubernetes détaille les changements de la bêta, avec la documentation et les exemples de démarrage.
Le dépôt GitHub external-snapshot-metadata héberge le code du composant qui expose ces métadonnées aux applications de sauvegarde.
—
Recherche, relecture et illustration assistées par IA. Le contenu reflète le travail éditorial de la rédaction.
No comments yet