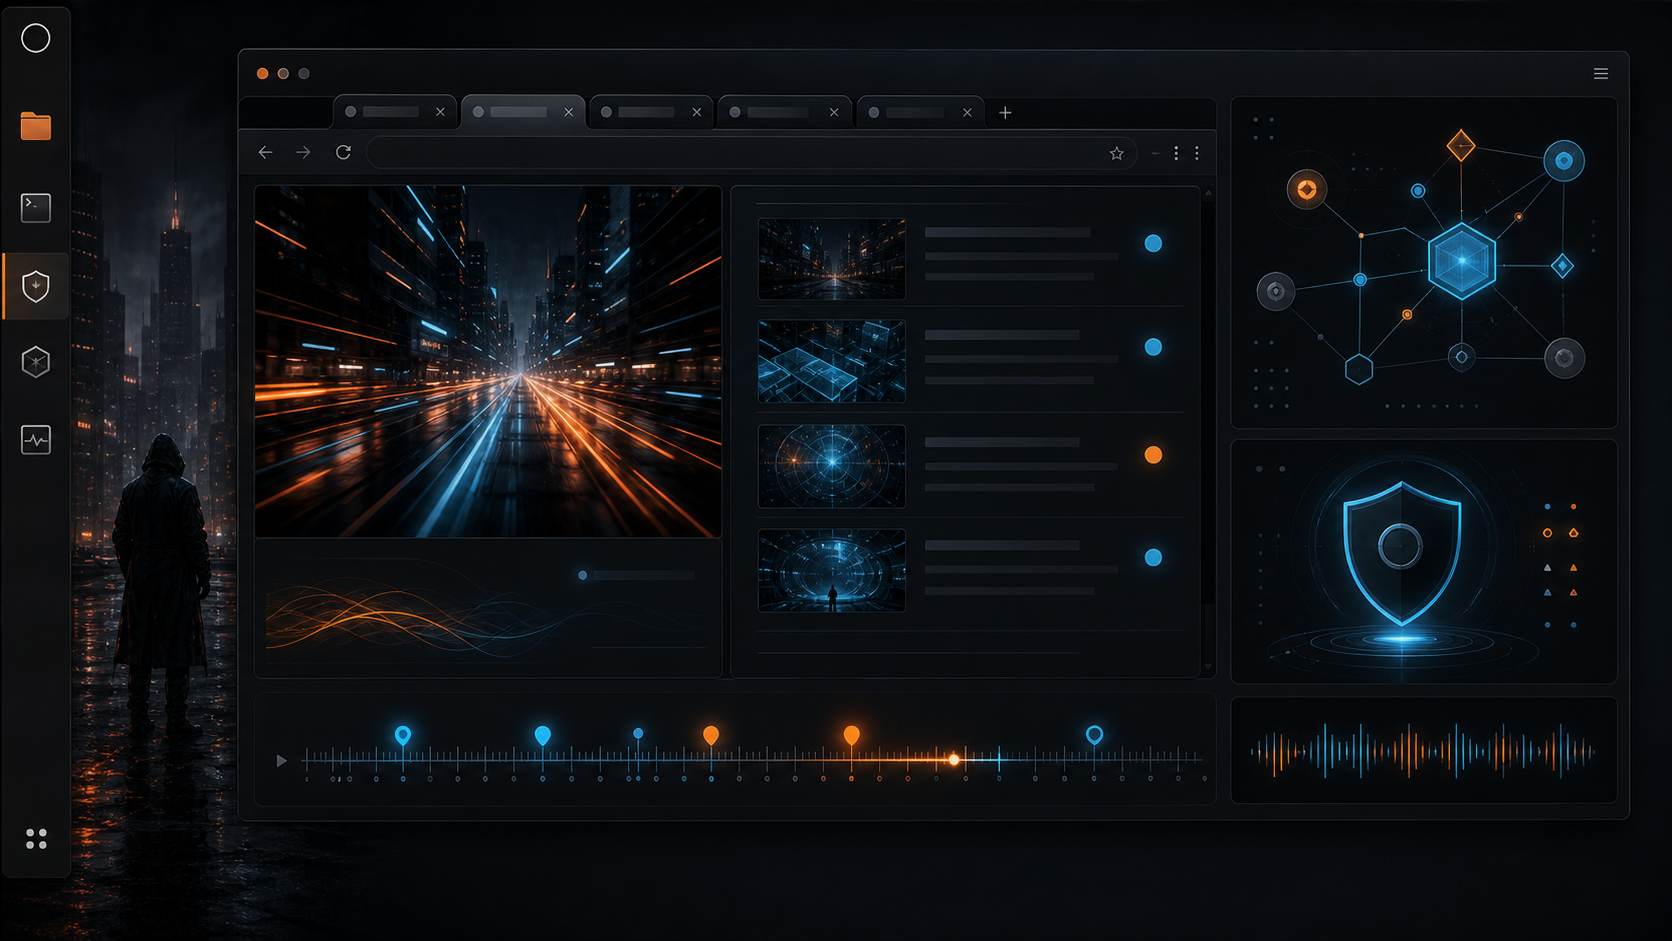
BrowserClaw est un navigateur pour agents IA qui part d’une idée simple et plutôt gênante pour les outils actuels : si ton agent doit réserver, répondre, comparer ou classer quelque chose, il lui faut tes sessions réelles, pas une fenêtre vide sur un serveur distant. Le projet, présenté comme le compagnon agentique de BrowserOS, vient de sortir en open source sous licence AGPL-3.0. Il propose de laisser l’agent agir dans un navigateur local, tout en gardant une trace lisible de ses clics, de ses pages et de ses erreurs.
Le navigateur ne repart plus de zéro
Les agents navigateur classiques savent souvent lire une page ou cliquer sur un bouton, mais ils butent au moment où commence le vrai travail : une boîte mail déjà connectée, un agenda, un outil interne ou un compte client. BrowserClaw traite ce problème comme un problème d’environnement, pas comme un simple manque de modèle. Tu installes le navigateur, tu ouvres tes sites comme d’habitude, puis l’agent utilise les sessions présentes dans ce profil pour exécuter une tâche.
La différence avec un navigateur cloud est importante. Le serveur du projet est censé écouter sur 127.0.0.1, l’adresse de boucle locale, et le dépôt décrit un fonctionnement où l’agent se connecte au navigateur par MCP. Cela ne rend pas l’automatisation inoffensive : cela déplace le point critique vers ta machine, tes cookies et les autorisations accordées à l’agent. Le confort est local ; le pouvoir l’est aussi.
Visuel officiel de l’écosystème BrowserOS et BrowserClaw. Source : BrowserOS, page d’accueil — https://browseros.com
MCP sert de prise, pas de baguette magique
BrowserClaw mise sur une connexion en un clic avec Claude Code, Cursor, Codex, VS Code, Zed et d’autres outils compatibles MCP. Pour les autres clients, la documentation prévoit une URL d’endpoint à copier. Le navigateur devient ainsi une surface d’exécution pilotable depuis un agent externe, au lieu d’un onglet que le modèle regarde vaguement.
Le dépôt distingue BrowserClaw de BrowserOS. BrowserClaw est le navigateur que l’agent conduit ; BrowserOS est le navigateur destiné à l’utilisateur, avec un agent intégré, des outils intégrés et des connexions à des applications. Les deux partagent le même socle de projet, mais ce ne sont pas deux noms pour exactement la même interface. Cette distinction compte si tu veux tester le produit sans transformer ton navigateur quotidien en cobaye.
La promesse technique est séduisante parce qu’elle colle à un usage concret : demander à un agent de remplir un formulaire, retrouver une information dans une interface ou préparer une réponse, puis observer la session en direct. Mais l’agent ne comprend pas magiquement la frontière entre « lire » et « agir ». Une connexion MCP bien pratique peut aussi devenir un tuyau vers des opérations que tu n’avais pas imaginées au départ.
L’audit local est la fonction qui change la discussion
La documentation met beaucoup l’accent sur l’audit et le rejeu. Chaque session de l’agent apparaît avec son état, son historique d’actions, ses onglets et, souvent, une capture de ce que le modèle regardait. Le rejeu ne se limite pas à une suite de captures : BrowserClaw annonce une lecture des changements DOM, des défilements et des clics comme une vidéo, avec une frise pour revenir à une étape précise.
Les données sont stockées dans ~/.browserclaw/. La base audit.sqlite conserve les appels d’outils et les bornes de session, le dossier screenshots les images d’étapes et le dossier replays les données de rejeu. Le serveur local ne devrait accepter que les requêtes de la machine. C’est une architecture plus inspectable qu’un tableau de bord distant, à condition de sauvegarder, protéger et supprimer réellement ces fichiers quand ils ne servent plus.
Le projet affirme aussi ne pas enregistrer les onglets personnels, parce que l’enregistreur n’est chargé que dans les onglets ouverts par l’agent. Les champs de mot de passe sont masqués avant l’enregistrement, mais cette protection ne doit pas être confondue avec une garantie générale contre les fuites. Une page peut afficher une adresse, un jeton dans une URL ou une information client sans la placer dans un champ marqué comme mot de passe.
✉️ Un moment, avant de continuer la lecture…
Le rendez-vous du dimanche : un extrait de la chronique « Un pavé dans la tech », les 4-5 infos qui comptent et un aperçu de la semaine à venir. Inscription gratuite, désinscription en un clic.
Local ne veut pas dire sans télémétrie
La page de confidentialité est plus nuancée que le slogan « rien ne sort ». Les URL, contenus de page, invites, résultats d’outils, captures, chemins de fichiers, mots de passe et clés d’API sont annoncés comme restant locaux. En revanche, BrowserClaw envoie par défaut des événements d’usage anonymes à PostHog : démarrage et arrêt, outils connectés ou déconnectés, version et système d’exploitation.
Le réglage peut être désactivé, et la documentation précise qu’aucun identifiant utilisateur n’est associé à cette télémétrie. C’est mieux qu’une collecte floue, mais ce n’est pas l’absence de collecte. Si tu déploies le navigateur sur une machine professionnelle, vérifie ce réglage avant de confier une session à un agent et considère le fournisseur du modèle comme une autre frontière : BrowserClaw ne contrôle pas ce que Claude, OpenAI, Cursor ou un autre outil fait de tes invites.
Le vrai test sera celui des permissions
Le lancement arrive dans un paysage où les agents navigateur sont déjà critiqués pour leur tendance à mélanger contenu non fiable et instructions. Un dépôt open source, un serveur local et un rejeu détaillé améliorent la visibilité, mais ils ne règlent pas à eux seuls le problème de l’autorité ambiante. Si l’agent peut utiliser ta session bancaire, ton webmail et ton espace de travail, une erreur de raisonnement devient une action avec tes droits.
La bonne manière de tester BrowserClaw consiste donc à commencer par un profil séparé, des comptes sans privilèges et des tâches réversibles. Active la confirmation avant les actions sensibles, surveille les onglets agentiques dans le tableau de bord et vérifie les journaux après chaque essai. Ne donne pas à un agent fraîchement installé les clés de toute ta vie numérique sous prétexte qu’il sait afficher une jolie frise de rejeu.
Le projet est intéressant précisément parce qu’il rend l’agent visible dans le navigateur que tu utilises déjà. Sa prochaine bataille ne sera pas de faire cliquer un bouton de plus, mais de prouver qu’il sait s’arrêter au bon moment, expliquer pourquoi il veut agir et respecter une permission qui ne se résume pas à « accès à tous les onglets ». Un agent que tu peux revoir est déjà mieux qu’un agent fantôme ; un agent qui sait dire non serait encore mieux.
Sources
BrowserOS, dépôt officiel GitHub, README — https://github.com/browseros-ai/BrowserOS — séparation BrowserOS/BrowserClaw, architecture, licence AGPL-3.0 et fonctionnalités annoncées.
BrowserOS, documentation officielle « BrowserClaw » — https://docs.browseros.com/browserclaw/index.md — sessions existantes, connexion aux agents, tableau de bord et rejeu.
BrowserOS, documentation officielle « Audit and replay » — https://docs.browseros.com/browserclaw/audit-and-replay.md — stockage local, étapes enregistrées, onglets concernés et fichiers d’audit.
BrowserOS, documentation officielle « Privacy and data » — https://docs.browseros.com/browserclaw/privacy.md — données locales, télémétrie PostHog et périmètre du fournisseur de modèle.
BrowserOS, page officielle — https://browseros.com — lancement de BrowserClaw, positionnement et compatibilité des plateformes.
—
Recherche, relecture et illustration assistées par IA. Le contenu reflète le travail éditorial de la rédaction.
No comments yet